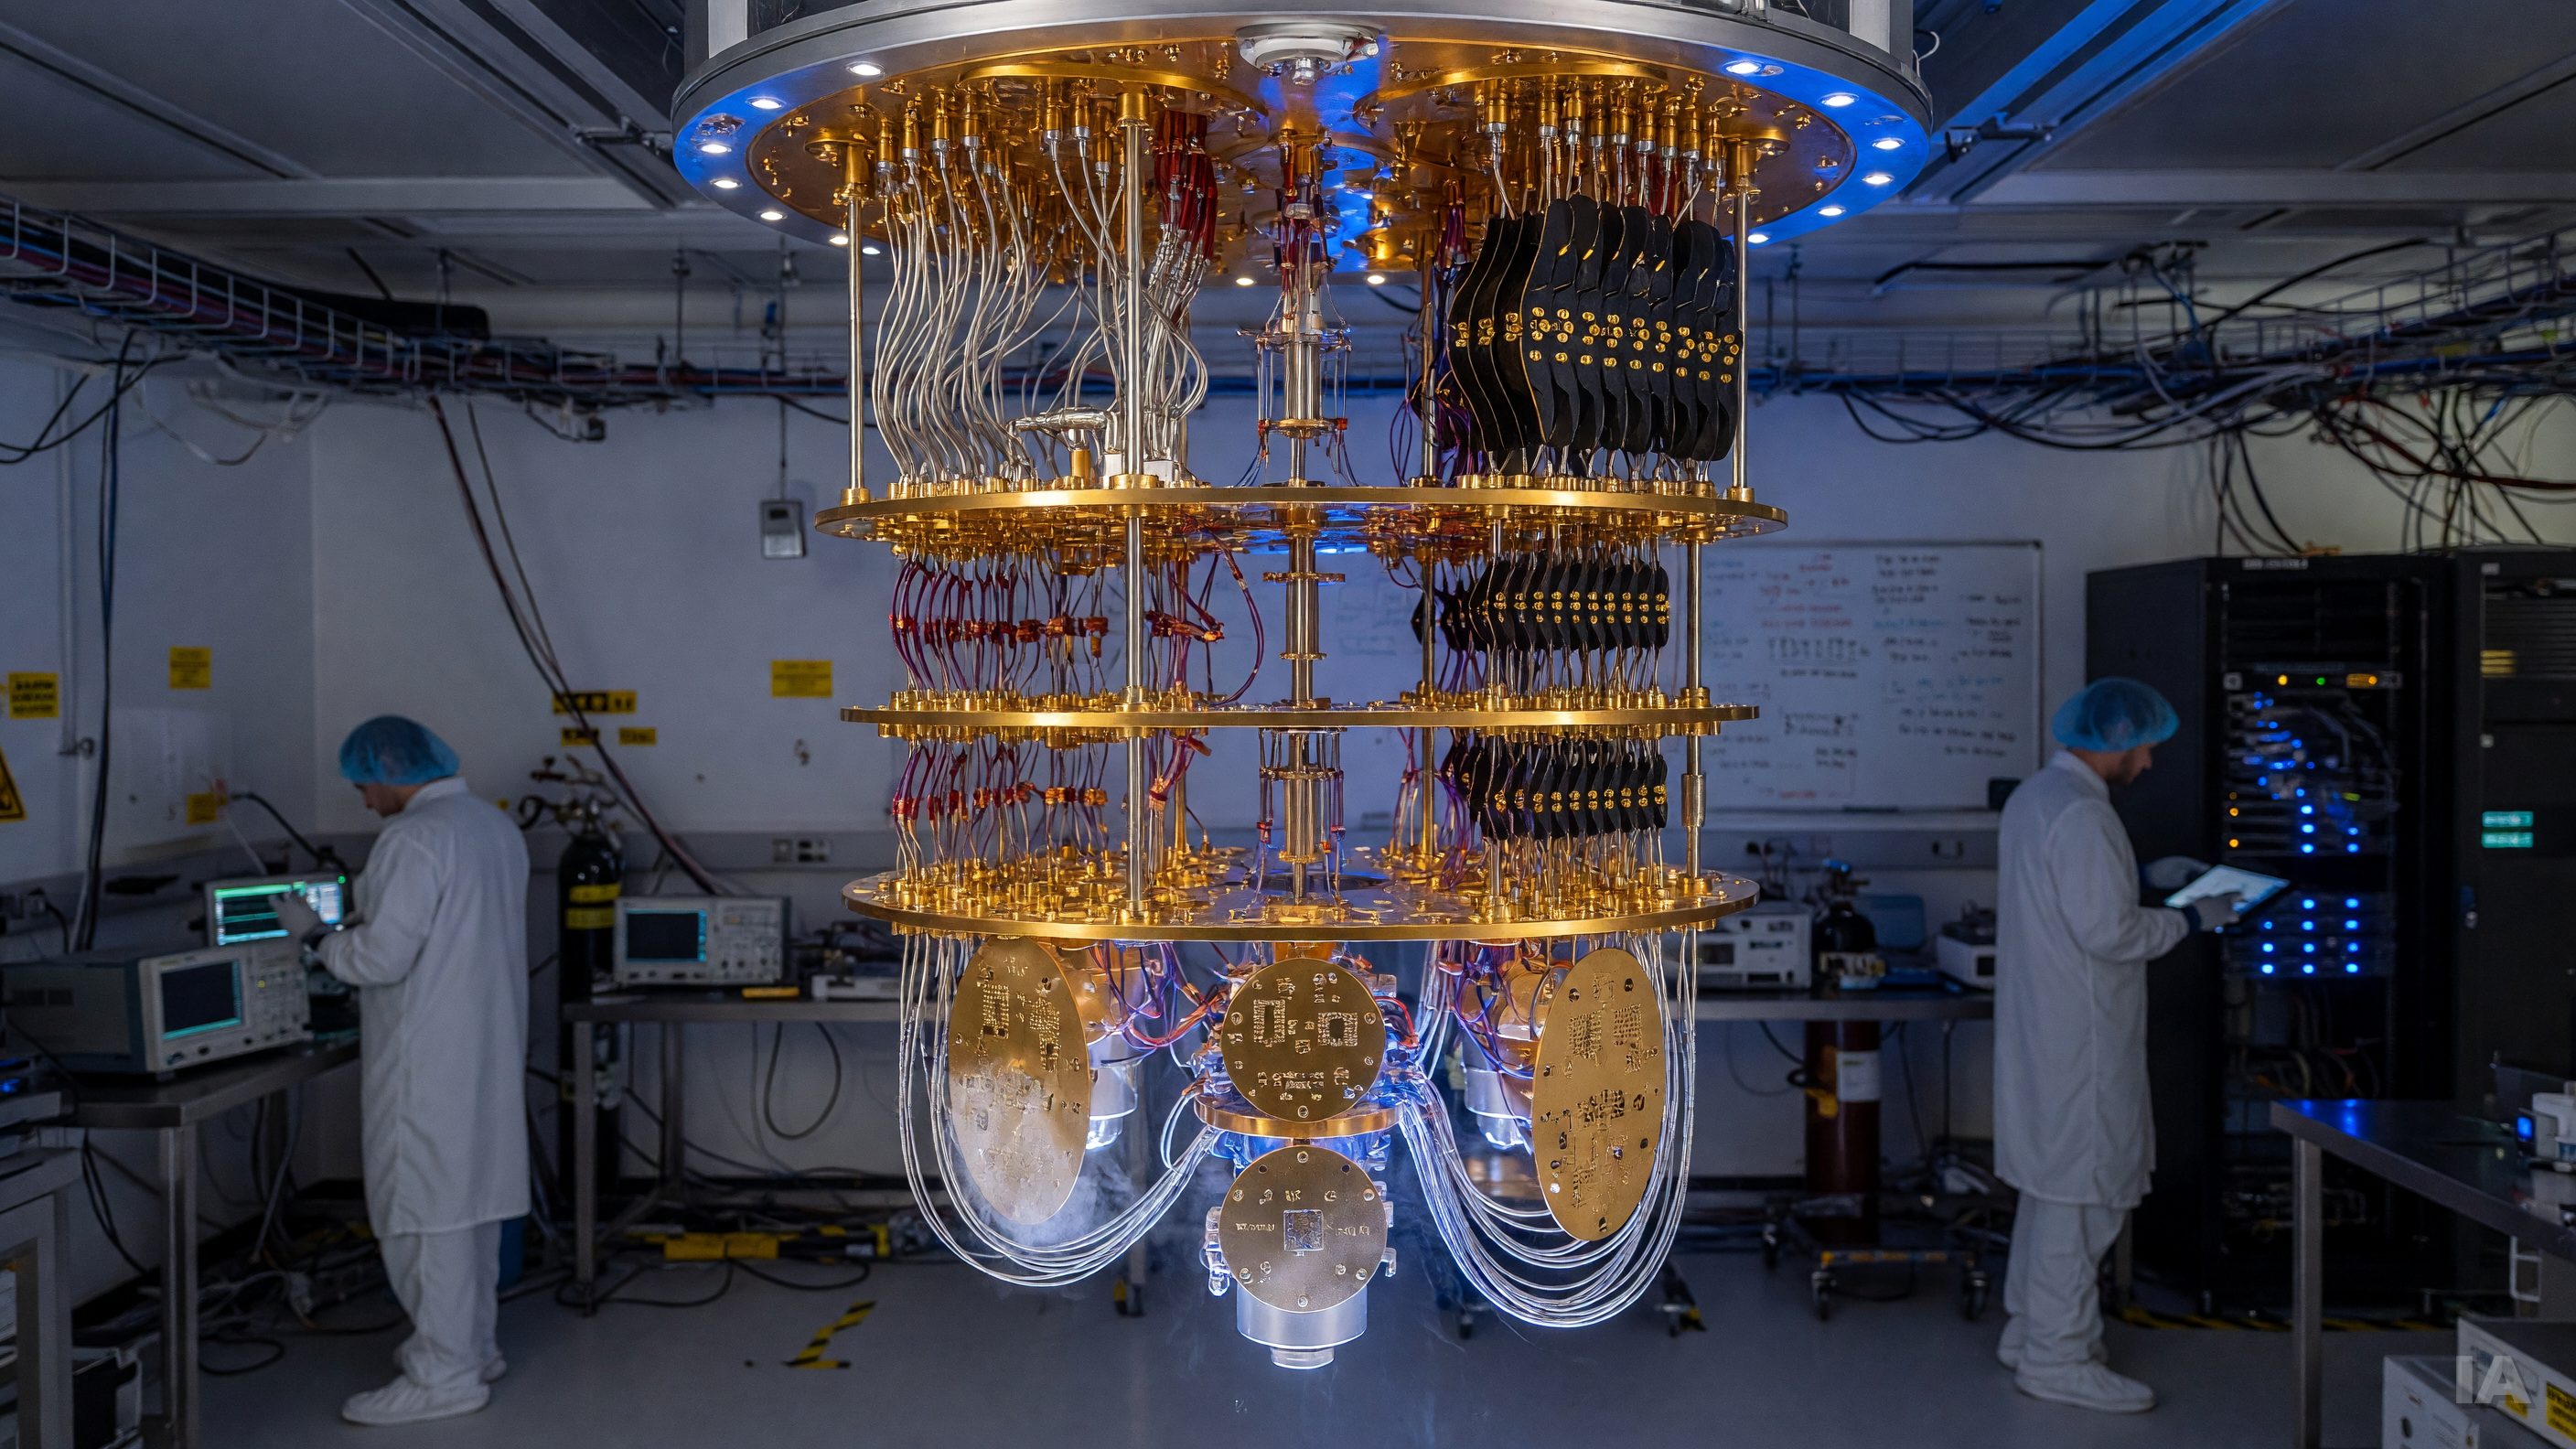
Combien de fois avez-vous lu qu'un nouvel ordinateur quantique était « le plus puissant au monde »? La formule revient à chaque annonce, et elle ne veut presque rien dire. Contrairement à l'informatique classique, où des suites de tests standardisées permettent depuis des décennies de classer les processeurs et les superordinateurs sur une même échelle, le calcul quantique n'a jamais disposé d'un thermomètre unique. C'est précisément ce vide que vient combler, selon Phys.org, un nouvel étalon conçu pour soumettre des machines de conceptions très différentes à une même épreuve — et pour mettre en lumière leurs limites plutôt que leurs records.
L'enjeu n'est pas cosmétique. Des milliards de dollars publics et privés sont engagés dans la filière, sur la promesse que ces machines finiront par résoudre des problèmes hors de portée des ordinateurs classiques : évaluation du risque financier, simulation de molécules complexes, optimisation de réseaux logistiques. Encore faut-il pouvoir vérifier qui progresse, et à quelle vitesse.
Pourquoi il est si difficile de comparer deux machines quantiques
Premier obstacle : les architectures n'ont presque rien en commun. Les qubits supraconducteurs, refroidis à quelques millikelvins, exécutent des portes logiques en dizaines de nanosecondes mais perdent leur information très vite. Les qubits à ions piégés, manipulés par lasers, sont mille fois plus lents, mais bien plus stables et interconnectables entre eux. Ajoutez les atomes neutres piégés par pinces optiques, les qubits photoniques, les qubits de spin dans le silicium, et vous obtenez des machines dont on ne peut pas simplement additionner les qubits pour établir un classement.
Deuxième obstacle : le nombre de qubits est une métrique trompeuse. Une puce de 1 000 qubits bruyants peut être moins utile qu'une machine de 50 qubits très fidèles, parce que la moindre erreur se propage dans le circuit. Ce qui compte, c'est la profondeur de calcul réellement atteignable avant que le signal ne se noie dans le bruit — une notion qui dépend du taux d'erreur des portes, de la qualité de la lecture, de la connectivité entre qubits et même de la façon dont le compilateur traduit l'algorithme en instructions physiques.
Troisième obstacle, plus inconfortable : les constructeurs ont un intérêt évident à choisir les tests qui les avantagent. Chaque entreprise a longtemps publié ses propres chiffres, mesurés selon ses propres conventions, sur des circuits de son choix. Dans ces conditions, une comparaison entre deux communiqués de presse relève davantage du marketing que de la métrologie.
Sept ans de tentatives, aucune convergence
Le problème n'est pas neuf. En 2018, des chercheurs d'IBM ont proposé le « volume quantique », une mesure obtenue en exécutant des circuits aléatoires carrés — autant de qubits que de couches d'opérations — et en cherchant la plus grande taille que la machine réussit encore à traiter correctement. L'indicateur, décrit dans un article déposé sur arXiv, a l'élégance de combiner en un seul nombre la taille, la fidélité et la connectivité. Il a aussi un défaut : il sature. Au-delà de quelques dizaines de qubits, il devient impossible à vérifier par simulation classique, et il ne dit rien du temps d'exécution.
D'où l'ajout, en 2021, d'une seconde dimension par la même équipe : les CLOPS, pour « circuit layer operations per second », soit la vitesse à laquelle une machine enchaîne les couches de circuit. Qualité, échelle, rapidité : le triptyque a fait école, mais il reste indifférent à la question qui intéresse les utilisateurs, à savoir la performance sur des problèmes concrets.
D'autres approches ont donc tenté le pari applicatif. IonQ a popularisé la notion de « qubits algorithmiques », Atos a proposé le Q-score, fondé sur la taille du problème d'optimisation qu'une machine parvient à résoudre, et plusieurs consortiums académiques ont publié des suites de tests inspirées d'algorithmes réels. Le Quantum Economic Development Consortium, qui regroupe aux États-Unis industriels, universités et laboratoires nationaux, développe depuis des années un ensemble de bancs d'essai ouverts précisément pour sortir des mesures maison. Résultat : une profusion d'étalons, et toujours pas de standard reconnu.
Ce que mesure un bon étalon
La nouveauté annoncée cette semaine s'inscrit dans cette généalogie. Selon Phys.org, l'exercice consiste à placer des systèmes différents sur une échelle unique afin de voir comment ils se comparent, et son intérêt principal tient moins au palmarès qu'au diagnostic : l'étalon révèle où chaque architecture décroche.
C'est là que se joue la valeur scientifique de ce genre d'outil. Un bon banc d'essai doit être indépendant du fabricant, applicable à des technologies hétérogènes, résistant à l'optimisation ciblée — on ne doit pas pouvoir « entraîner » sa machine à réussir le test — et vérifiable, c'est-à-dire assorti d'une manière de contrôler la justesse du résultat sans devoir simuler tout le calcul sur un superordinateur classique. Cette dernière exigence est la plus dure à satisfaire, et c'est elle qui a nourri les controverses des dernières années.
Le fond du débat : l'avantage quantique est une cible mouvante
L'histoire récente est en effet une succession d'annonces suivies de révisions. Les expériences d'échantillonnage de circuits aléatoires, utilisées depuis 2019 pour proclamer la « suprématie quantique », ont été rattrapées à plusieurs reprises par des algorithmes classiques améliorés. En 2023, IBM a publié dans Nature des résultats présentés comme une démonstration d'utilité du calcul quantique avant l'ère de la correction d'erreurs, sur un modèle de spins; en quelques semaines, plusieurs équipes ont reproduit ces résultats sur des ordinateurs classiques avec des méthodes de tenseurs. L'épisode a été salutaire : il a montré qu'un étalon sans référence classique solide ne prouve rien.
En parallèle, la vraie rupture s'est jouée du côté de la correction d'erreurs. Fin 2024, Google a publié dans Nature une expérience sur sa puce Willow montrant qu'un code de surface franchissait le seuil critique : en augmentant le nombre de qubits physiques par qubit logique, le taux d'erreur diminuait au lieu d'augmenter. Cette démonstration déplace la question de la mesure. Demain, ce ne sont plus des qubits physiques qu'il faudra comparer, mais des qubits logiques — leur nombre, leur fidélité, le coût en ressources physiques et la vitesse des opérations qu'on peut leur appliquer.
Les agences publiques ne s'y trompent pas. La Quantum Benchmarking Initiative de la DARPA, aux États-Unis, a été bâtie sur une idée simple et brutale : plutôt que de financer des prototypes, l'agence évalue les feuilles de route d'entreprises concurrentes pour déterminer lesquelles peuvent plausiblement mener à un ordinateur quantique utile à l'échelle industrielle, avec des équipes d'experts chargées de vérifier les prétentions techniques. C'est du parangonnage appliqué non plus aux machines, mais aux promesses.
Ce qui change
Un étalon commun ne rendra pas les ordinateurs quantiques plus puissants. Il rendra le discours plus honnête, et c'est déjà considérable dans un secteur où l'écart entre les communiqués et les capacités réelles alimente régulièrement la crainte d'une bulle. Pour les acheteurs potentiels — banques, groupes pharmaceutiques, transporteurs, centres de calcul nationaux —, disposer d'une mesure indépendante est la condition pour décider quand il devient rationnel d'investir, et sur quelle technologie.
Il y a aussi un bénéfice proprement scientifique. Les étalons qui révèlent des limites sont plus utiles que ceux qui produisent des records : ils indiquent aux ingénieurs quel goulot d'étranglement attaquer, le temps de cohérence, la connectivité, la vitesse de lecture ou la compilation. L'informatique classique a mis des décennies à se doter de suites de tests crédibles, régulièrement contestées et révisées. Le calcul quantique en est au tout début de ce travail ingrat, et c'est peut-être le signe le plus fiable que le domaine sort de l'âge des démonstrations spectaculaires pour entrer dans celui de l'ingénierie.