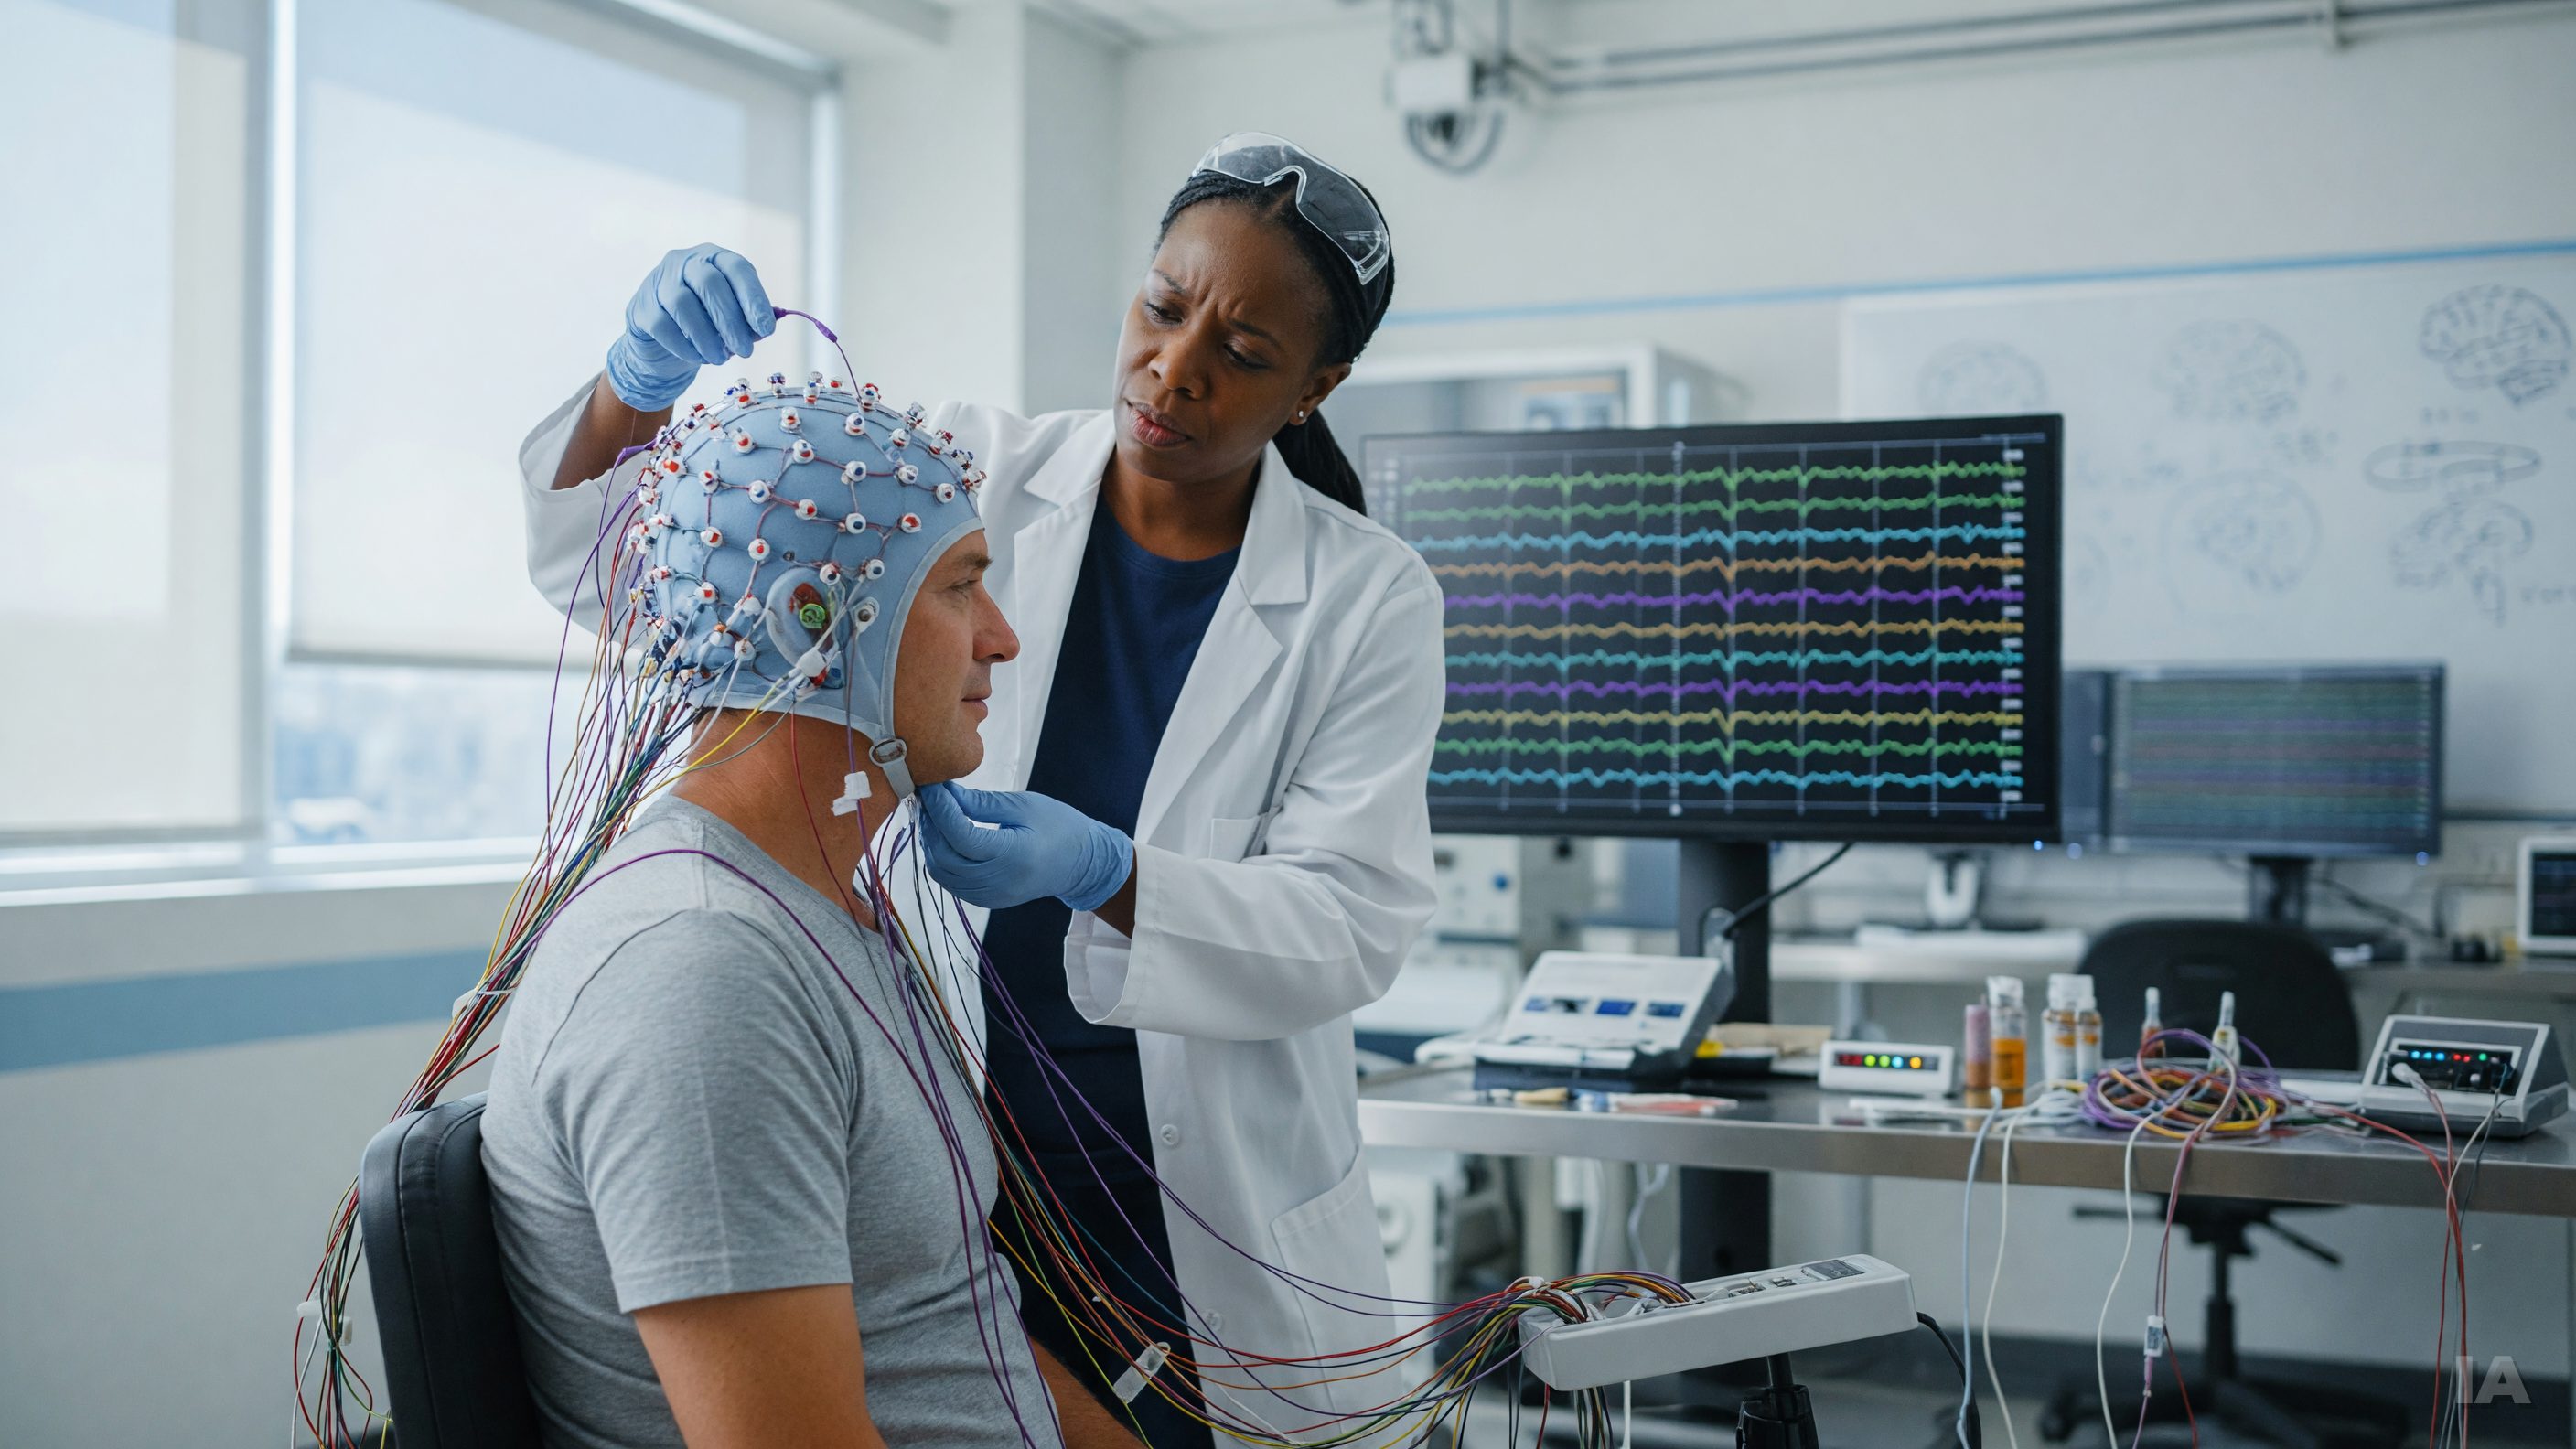
Rêver d'une interface qui traduirait en mots ce que vous vous dites mentalement, sans un son ni un geste, est l'un des fantasmes les plus tenaces de la communication homme-machine. Deux articles déposés cette semaine sur arXiv, dans les sections consacrées à l'intelligence artificielle et aux neurosciences quantitatives, tempèrent l'enthousiasme sans l'éteindre. Ils s'intéressent à un obstacle très concret : un décodeur de parole imaginée fonctionnerait-il chez une personne qu'il n'a jamais « vue »? Leur réponse repose surtout sur une exigence de méthode, plus que sur une prouesse technique.
Le problème de départ : calibrer à chaque utilisateur
La parole imaginée, aussi appelée parole intérieure, désigne le fait de prononcer mentalement des mots sans les articuler. Les interfaces cerveau-machine qui tentent de la décoder reposent le plus souvent sur des implants posés à même le cortex, particulièrement efficaces chez des patients paralysés qui ne peuvent plus parler. Mais la chirurgie limite leur diffusion. L'électroencéphalographie (EEG) du cuir chevelu, elle, ne demande qu'un bonnet d'électrodes : elle est non invasive, peu coûteuse et utilisable en dehors de l'hôpital. En contrepartie, le signal est bruité, atténué par le crâne et très variable d'une personne à l'autre, et même d'une séance à l'autre chez un même individu.
C'est là que se situe la question centrale de la première étude, dont le titre se traduit par « Décodage interindividuel de la parole imaginée à partir de l'EEG du cuir chevelu : une évaluation sans fuite de données sur trois corpus publics ». Ses auteurs partent d'un constat de bon sens : un décodeur qui fonctionnerait chez un nouvel utilisateur sans calibration préalable rendrait une interface de parole non invasive véritablement pratique. Aujourd'hui, chaque personne doit d'abord passer de longues séances d'enregistrement pour entraîner un modèle à ses propres signaux. Supprimer cette étape serait un changement d'échelle.
Les chercheurs testent donc si le contenu de la parole imaginée, enregistré par EEG, se transfère d'un individu à l'autre. Ils examinent aussi une question voisine, presque embarrassante pour le domaine : pourquoi la précision reste-t-elle faible, même lorsqu'on entraîne et teste le modèle sur une seule et même personne?
Ce que « sans fuite de données » veut dire
Le titre de l'étude met en avant un terme technique qui mérite d'être expliqué : la « fuite de données ». En apprentissage automatique, on parle de fuite lorsque des informations du jeu de test se glissent, directement ou indirectement, dans l'entraînement du modèle. Le résultat paraît alors meilleur qu'il ne l'est réellement, parce que le modèle a, en quelque sorte, vu les réponses.
Le problème est particulièrement insidieux avec l'EEG. Les enregistrements cérébraux portent la signature de la séance : l'état de fatigue du participant, la position du bonnet, le bruit électrique de la salle, la dérive lente du signal. Si des essais issus d'une même séance se retrouvent à la fois dans l'entraînement et dans le test, un modèle peut apprendre à reconnaître la séance plutôt que le mot imaginé. Il obtient alors un score flatteur sans rien avoir compris de la parole. L'évaluation « sans fuite » consiste à séparer strictement les participants, ou au minimum les séances, entre l'apprentissage et le test, de façon à mesurer ce qu'un système ferait réellement devant un inconnu.
La démarche s'appuie sur trois corpus publics, ce qui est un choix important en soi. Travailler sur des données ouvertes permet à d'autres équipes de reproduire l'analyse, de la contester et de la prolonger. C'est précisément ce qui manque à beaucoup de revendications spectaculaires dans le domaine.
Le second article : que pouvait-on raisonnablement détecter?
Une deuxième publication, déposée dans la section de neurosciences quantitatives d'arXiv, prolonge le raisonnement, avec un titre qu'on peut rendre ainsi : « Quelle ampleur d'effet aurions-nous observée? Témoins positifs, seuils de détection et pièges des jeux de données dans le décodage de la parole par EEG du cuir chevelu ». Elle s'attaque à une habitude répandue : valider un protocole d'analyse à l'aide d'un témoin positif, généralement la parole prononcée à voix haute, dont l'activité cérébrale est plus intense et plus facile à décoder. Si le protocole « marche » sur la parole audible, on conclut que l'outil est fiable, puis on constate qu'il ne trouve rien sur la parole imaginée.
Le défaut de ce raisonnement, soulignent les auteurs, est qu'un résultat nul n'a de valeur que si l'on sait quelle taille d'effet la méthode aurait été capable de déceler. Dire « nous n'avons rien trouvé » sans préciser le seuil de détection revient à ne rien dire : l'effet pourrait exister et être simplement trop faible pour l'instrument. Les chercheurs réanalysent plusieurs jeux de données, dont ds003626, intitulé « Thinking out loud », le corpus KaraOne et la piste 3 du défi de 2020 consacré à la parole imaginée, afin d'illustrer ces pièges.
Pris ensemble, les deux textes dessinent une même posture : avant de se demander si l'on peut décoder la pensée verbale à travers un bonnet d'électrodes, il faut s'assurer que les chiffres qu'on publie signifient bien ce qu'on croit.
Ce que ces travaux disent, et ce qu'ils ne disent pas
Il convient de rester prudent : les deux articles sont des prépublications. Ils n'ont pas été évalués par des pairs au moment de leur dépôt, et leurs conclusions doivent être lues comme telles. Le résumé de la première étude que nous avons pu consulter énonce la question posée et la méthode, sans que nous puissions, à ce stade, en détailler l'ensemble des chiffres. Nous nous abstenons donc de rapporter des taux de précision précis.
Ce que l'on peut dire avec assurance, c'est la direction que prend la discipline. Après des années de résultats prometteurs mais difficiles à comparer, une partie de la communauté insiste sur des protocoles stricts, des seuils de détection explicites et des corpus partagés. Ce virage rappelle celui qu'ont connu d'autres domaines de l'apprentissage automatique, où l'on a découvert que des performances spectaculaires s'effondraient dès qu'on corrigeait les fuites de données.
Il faut aussi replacer l'enjeu dans son contexte. Le décodage de la parole par implants cérébraux a, ces dernières années, produit des démonstrations marquantes chez des patients atteints de paralysie sévère. L'EEG de surface joue dans une autre catégorie : son attrait tient à l'accessibilité, pas à la finesse du signal. Atteindre un décodeur universel, valable pour tout nouvel utilisateur, demanderait que les motifs neuronaux liés à un mot imaginé soient suffisamment communs d'une personne à l'autre pour être captés à travers le crâne. Rien n'indique pour l'instant que ce soit le cas, et c'est précisément ce que ces évaluations rigoureuses cherchent à établir.
Pourquoi c'est important
L'enjeu dépasse la curiosité scientifique. Une interface de parole non invasive et sans calibration ouvrirait des perspectives pour des personnes qui ne peuvent plus communiquer oralement, sans passer par la chirurgie. Elle pose aussi, d'emblée, des questions éthiques que le public n'a pas fini d'examiner : celle de la vie privée mentale, de la possibilité de lire des contenus que la personne n'a pas choisi de dire, et du consentement à l'enregistrement de signaux cérébraux. Plus la technologie se rapproche de la pensée verbale, plus ces questions deviennent concrètes.
C'est justement pour cette raison que la rigueur méthodologique compte. Des annonces gonflées par des fuites de données alimentent à la fois de faux espoirs chez les patients et de fausses craintes dans le public. Une évaluation honnête, qui dit ce que l'on peut et ne peut pas détecter, sert les deux camps : elle protège les malades contre les promesses creuses et le débat éthique contre les scénarios fantaisistes.
La suite
La suite dépendra des vérifications indépendantes. Si les conclusions de ces travaux tiennent après évaluation par les pairs et reproduction sur d'autres corpus, elles serviront de balise : toute future revendication de décodage interindividuel de la parole imaginée par EEG devra démontrer qu'elle résiste à une séparation stricte des participants et qu'elle précise le seuil d'effet qu'elle pouvait déceler. En attendant, la parole intérieure garde son caractère privé, au moins pour les bonnets d'électrodes disponibles aujourd'hui.